Hiển thị các bài đăng có nhãn Machine Learning. Hiển thị tất cả bài đăng

Thứ Bảy, 19 tháng 1, 2019

Semantic Segmentation

Đầu tiên ta nhắc lại về segmentation. Với segmentation, đầu vào là ảnh và đầu ra là các đường bao ứng với các vật thể và phân tách các vật thể trong ảnh.
Còn semantic segmentation, ta cần hiểu ảnh đầu vào ở mức ngữ nghĩa sâu hơn không chỉ là các đường bao vật thể.
Ví dụ với ứng dụng cho việc image captioning, với ảnh góc trên bên phải, ta có:
"Two men riding on a bike in front of a building on the road. And there is a car."
Rõ ràng việc ngữ nghĩa (semantic) là công việc khó hơn và đòi hỏi kỹ thuật phức tạp hơn việc chỉ segmentation đơn thuần. Nhưng tiềm năng của semantic segmentation lại lớn hơn nhiều, khi mà ta có thể hiểu được toàn bộ bức ảnh và áp dụng vào các mảng khác nhau như y tế, giao thông ...

Về cơ bản, semantic segmentation có thể hiểu như:
- Phụ thuộc vào CRF (Conditional Random Field)
- Thực hiện ở mức pixel hoặc superpixel
- Phân tích sự liên quan giữa các pixel gần nhau
- Sử dụng sự liên quan giữa các label gần nhau

Để hiểu 4 điều trên, ta hãy nhìn vào 1 ví dụ:
- Các pixels gần nhau thường có xác suất có cùng label
- Các pixels có cùng màu thường có xác suất có cùng label
- Pixels phía trên pixels "chair" thường có xác suất là pixel "person" thay vì "building" 

Vậy CRF là một mô hình dựa vào xác suất để có thể đưa ra các dự đoán về các pixels trên 1 ảnh.

Định nghĩa của superpixel là:
The concept of superpixel was first introduced by Xiaofeng Ren and Jitendra Malik in 2003. Superpixel is a group of connected pixels with similar colors or gray levels. Superpixel segmentation is dividing an image into hundreds of non-overlapping superpixels. Instead of working with just pixels, Ren and Malik use superpixels to do image segmentation.
There are two major advantages for using superpixels.
- you can compute features on more meaningful regions.
- you can reduce the input entities for the subsequnt algorithms.
Superpixel segmentation have been applied to many computer vision tasks, such as sematic segmentation, visual tracking, image classification, and so on.

Thứ Ba, 1 tháng 1, 2019

[Machine Learning][Deep Learning] Bidirectional RNN

Như ta đã đề  cập trước đó, trong các ứng dụng, ví dụ Name Entity Recognition, cho một đầu vào x(t) ở thời điểm t, để xác định x(t) có phải là 1 entiry cần tìm hay không, ta cần phải lấy thông tin không chỉ từ các dữ liệu trước thời điểm t mà còn phải sau thời điểm t. Ví dụ trong câu sau:
He said: "Teddy Roosevelt was a great president!"

Giả sử x(3) là Teddy, x(4) là Roosevelt, khi này ta sẽ cần xem xét cả các dữ liệu đằng sau để đưa ra quyết định x(3) và x(4) có phải entity cần tìm hay không.
Mô hình BRNN được cho bởi hình dưới đây:
Lúc này , thay vì chỉ có 1 đường forward, ta sẽ có thêm 1 đường backward, với mỗi giá trị ví dụ để tính toán output y3, tất cả các giá trị input xi đều sẽ tham gia. Các block trong mạng có thể là GRU block hoặc LSTM block.

Tuy nhiên, một nhược điểm của BRNN là ta chỉ có thể áp dụng mô hình này nếu toàn bộ tập dữ liệu đầu vafolaf biết trước, do đó các ứng dụng yêu cầu đáp ứng real-time có thể sẽ bị hạn chế.
Ví dụ như trong ứng dụng Speech Recognition, người dùng phải nói hết câu thì hệ thống mới có thể thực hiện.
Dù vậy, trong các ứng dụng về NLP, hầu hết các input là các corpus nên ta có thể sử dụng BRNN.

[Machine Learning][Deep Learning] Kiến trúc Long Short Term Memory (LSTM) trong RNN

Trong kiến trúc LSTM, c<t> và a<t> sẽ không tương đương nữa, lúc này LSTM sẽ gồm 3 gates Γu, Γf  và Γo.
Mỗi gate đều được tính toán từ a<t-1> và x<t>, sơ đồ của 1 unit được mô tả như hình dưới đây.
Khi này, dựa vào các giá trị của các gate, ta cũng có thể sử dụng những feature xa trong 1 sequence hoặc giải quyết được vanishing/exploding gradient. LSTM là một mô hình tổng quát hơn và ra đời trước GRU rất lâu. Ta có thể thấy GRU là mô hình đơn giản hơn LSTM nhiều do đó ta có thể xây dựng được các hệ thống lớn hơn, tuy nhiên LSTM lại có performance cao do nó có 3 gates thay vì 2 gates của GRU. 

Thứ Hai, 31 tháng 12, 2018

[Machine Learning][Deep Learning] Kiến trúc Gated Recurrent Unit (GRU) trong RNN

Kiến trúc của 1 unit trong 1 RNN như ta đã đề cập trước đó có mô hình như dưới đây:
Lúc này, a<t> sẽ phụ thuộc vào chuỗi dữ liệu trước đó bên cạnh tác động của exploding/vanishing gradient.
Ví dụ trong câu: The cat, which already ate two big fishes and three apples ..., was full.
Lúc này The cat là số ít sẽ đi kèm với động từ tobe was, tuy nhiên ở giữa lại là 1 chuỗi dài, và trong RNN thường, ta không thể sử dụng feature The cat do chủ ngữ The cat và động từ was cách xa nhau trong chuỗi.

Một kiến trúc mới của RNN là GRU sẽ giải quyết vấn đề này.
Trong GRU, ta định nghĩa c là 1 memory cell, và c<t> = a<t> (a<t> trong RNN thường, nhưng trong GRU, ta dùng c<t> thay vì a<t>). Γu là hàm gate được tính bởi sigmoid function sẽ có giá trị xấp xỉ 0 hoặc 1. Với mỗi thời điểm t, Γu sẽ quyết định việc update c<t> = č<t> bằng biểu thức sau đây:

Nghĩa là nếu Γu = 1, ta sẽ update, nếu Γu=0, giá trị c<t> = c<t-1>, không có sự biến đổi trong mạng RNN. Do vậy trong chuỗi đã cho ở phần đầu, ta sẽ xác định được những step nào nên có sự biến đổi và những step nào nên được giữ nguyên.
Ở đây ta thấy chỉ có cat và was sẽ được update, những step t giữa chúng sẽ có giá trị  Γu=0 ứng với việc giữ nguyên. Do đó, ta có thể coi như trong câu chỉ còn The cat was full vì các step t có giá trị Γu=0 sẽ không đóng vai trò trong việc tính toán output. Thực ra vai trò của chúng là rất nhỏ vì Γu là xấp xỉ bằng 0, nhưng do đi qua nhiều step t, nên giá trị này trở nên nhỏ vô cùng gần 0, do đó ta vừa có thể tính toán output từ 1 step t rất ra trước đó, vừa có thể khắc phục vanishing hoặc exploding gradient khi mà ta bỏ qua hầu hết những thành phần không quan trọng trong sequence.

Mô hình đơn giản của 1 GRU unit sẽ như sau:

Thực tế trong mô hình GRU, ta có thêm 1 gate nữa là Γr trong đó gate này thể hiện sự giống nhau giữa c<t-1> và č<t>.
Mô hình GRU lúc này sẽ gồm 2 gate được biểu diễn như sau:


[Machine Learning] Vanishing và exploding gradient trong Neural Network

Thuật toán Gradient Descent dùng để để tìm cực tiểu của hàm cost ứng với các parameter của 1 NN. Trong NN, thông tin được tính toán từ trái qua phải, bắt đầu với input và kết thúc bởi output, trong khi đó, loss được tính và back propagation được tính theo chiểu ngược lại để ta có thể update các parameter trong mỗi qua mỗi iteration.
RNN cũng hoạt động tương tự, nhưng vì dữ liệu trong RNN là sequence nên sẽ có 2 điểm khác biệt.
- Dữ liệu đầu vào ở trạng thái hiện tại chính là đầu ra của trạng thái trước đó.
- Với mỗi thời điểm t nhất định, ta có thể tính toán cost function một cách độc lập.
Trong hình trên, với mỗi thời điểm t ta đều có thể tính toán error εt. Để tính toán và update các parameter, ta phải thực hiện back propagation từ chiều output quay ngược lại. Mỗi 1 neuron trong mạng đều tham gia vào quá trình tính toán ra output cuối cùng cũng như cost function, thông số của các neuron này cần tìm là các giá trị để cost function đạt cực tiểu. Tuy nhiên, trong RNN, mọi neuron từ neuron đầu tiên tới neuron cuối cùng đều tham gia vào quá trình này, do vậy, ta sẽ phải thực hiện back proapgate through time cho tất cả các neuron.
Vấn đề sẽ nằm ở việc update ma trận trọng số wrec.
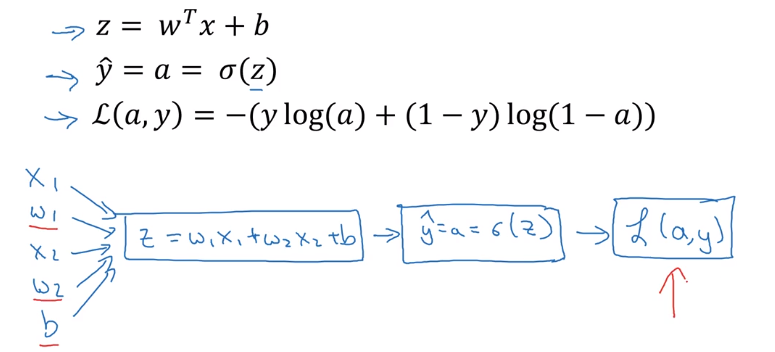
Để tính toán xt-2 ta sẽ cần nhân xt-3 với wrec hoặc muốn tính xt-1 ta sẽ cần nhân xt-2 với wrec . Ma trận trọng số wrec là giống nhau trong toàn mạng RNN, dó vậy, nếu wrec nhỏ, giá trị gradient sẽ nhỏ, và nhỏ dần khi số lượng layer trong RNN là lớn, và giá trị này giảm theo hàm mũ.

Ta đã biết rằng ma trận này được khởi tạo lúc ban đầu với các giá trị mặc định xấp xỉ 0 và từ đó ta thực hiện train mạng NN. Tuy nhiên, nếu ra khởi tạo ma trận trọng số theo cách này và nhân với các giá trị xt, xt-1, xt-2, xt-3, … gradient sẽ giảm nhanh sau mỗi phép nhân - vanishing gradient. Tương tự nếu giá trị này là lớn, khi đó gradient tăng nhanh và sẽ xảy ra hiện tượng tràn số, lúc này giá trị gradient ta nhận được sẽ là NaN, đây là hiện tượng exploding gradient.

Giá trị gradient càng nhỏ, NN sẽ khó để update các parameter và tốc độ converge của cost function sẽ chậm hơn rất nhiều. Ví dụ ta chỉ cần 1000 epochs để có thể tìm được giá trị tối ưu cho parameter tại thời điểm t, tuy nhiên 1000 epochs sẽ không đủ cho thời điểm t-3 do lúc này gradient đã bị giảm đi rất nhiều.
Ta có thể nghĩ rằng vậy ta có thể train đúng cho nửa mạng, nghĩa là từ t trở đi là đúng, còn t quay lại là sai, tuy nhiên tất cả mạng NN của ta sẽ bị train sai. Giải thích đơn giản là vì output của layer trước là input của layer sau, nếu ta train tại thời điểm t mà input lấy tại layer chưa được train trước đó, lúc này việc training ở thời điểm t sẽ trả về giá trị sai.

Kiến trúc Gated Recurrent Unit (GRU) hoặc Long Short Term Memory (LSTM) sẽ giải quyết vấn đề này.

Chủ Nhật, 30 tháng 12, 2018

[Machine Learning][Deep Learning] Recurrent Neural Network


  • Sequence data
Sequence data hay dữ liệu tuần tự là loại dữ liệu mà các thành phần phụ thuộc lẫn nhau về mặt thời gian hay ngữ nghĩa, ví dụ: 1 đoạn audio, 1 câu nói, hoặc 1 chuỗi DNA ...
  • Tại sao không dùng Neural Network thường (Standard Neural Network) như hình dưới.
Với các dữ liệu dạng tuần tự, khi ta dùng NN thường (có input, hidden layer và output) sẽ có 2 hai vấn đề:
- Các dữ liệu đầu vào là không cùng length, mà với NN thường, các thông số này phải được xác định trước ví dụ như số units của input layer, output layer.
- Các dữ liệu xử lý trong NN thường là các dữ liệu độc lập nghĩa là chúng không liên quan tới nhau, mà trong dữ liệu tuần tự, ta muốn quan sát các dữ liệu xung quanh để tính toán đầu ra một cách chính xác. Ví dụ như trong câu: The president of US is George Bush, khi này nếu ta đang xây dựng 1 mô hình Name Entity Recognition (NER), để phát hiện George Bush là tên người, nếu mạng NN biết được president là 1 danh từ chỉ người có trong câu khi đó đầu ra sẽ chính xác hơn (confidence score sẽ cao hơn).
  • Kiến trúc RNN
RNN được cho bởi kiến trúc như hình sau:
Các đầu ra ŷ<t> sẽ phụ thuộc vào đầu vào x<t> cũng như các dữ liệu trước đó được cho bởi a<t-1>. Lúc này, ta có thể tận dụng các feature của các sample xuất hiện trước đó trong 1 chuỗi.
Tuy nhiên, mô hình RNN lại có 1 nhược điểm đó là nó chỉ có thể tận dụng các feature của các sample xuất hiện trước đó mà không thể tận dụng các sample ở phía sau. Khi này, một mô hình mới là Bidirectional RNN được đề xuất để giải quyết vấn đề này.
Ngoài ra, trong RNN, ta vẫn phải thực hiện forward và back propagation. Khi thực hiện back propagation, t sẽ giảm dần nghĩa là ta quay ngược lại thời gian theo ngược chiều của chuỗi được cho, lúc này thuật toán được gọi là back propagation through time (BPTT)

Thứ Năm, 27 tháng 12, 2018

[Machine learning] Hyperparameters vs parameters

Trong một mạng NN, ta có các thông số cần phải tìm để tối ưu mạng đó là W và b cho các layers.

Các thông số (paramters) mà tác động đến W và b được gọi là các hyperparameters, có thể liệt kê:
+ Learning rate alpha
+ Số lần iterations
+ Số hidden layers
+ Số units trong hidden layers
+ Hàm activation nào được chọn v.v.

Applied deep learning is a very empirical process - Andrew Ng

Nghĩa là trong các ứng dụng về DL, công việc chủ yếu của ta là đi tìm các hyper parameters, và tìm các tham số này phải giải quyết bằng thực nghiệm theo như sơ đồ dưới đây.
Ví dụ ta muốn tìm hyperparameter learning rate, khi đó ta phải thử với rất nhiều các giá trị alpha khác nhau và có thể cần vẽ hàm cost để thấy được tác động của learning rate lên quá trình convergence.

[Machine Learning] Deep neural network vs shallow neural network

Trong bài trước, khi ta nhắc đến shallow neural network, ta hiểu rằng đây là mạng nơ ron mà chỉ có một hoặc hai hidden layer, thực ra con số này là không định lượng, việc ta nói shallow và deep chỉ để phân biệt rằng hai kiến trúc mạng một kiến trúc sử dụng số lượng nhỏ và mạng còn lại sử dụng số lượng lớn hidden layer. Trái lại, trong deep neural network, số lượng hidden layer lớn hơn nhiều. Như đã nói ở trước, khi nói về số lớp của 1 mạng, ta sẽ bỏ qua input layer, do đó với hình dưới đây, logistic regression cũng có thể coi là một mạng neuron với chỉ 1 lớp.

Khi thực hiện tính toán forward propagation và back propagation trong Deep NN, ta cũng phải thực hiện tuần tự qua từng layer, ví dụ như với hình trên là 2 hidden layer, khi này ta sẽ phải lần lượt tính z1, a1, z2, a2 tương ứng với 2 hidden layer. 
Ta nên để ý và phân biệt rõ 2 khái niệm: hidden layer và layer của 1 mạng khi layer của 1 mạng được hiểu như là số lượng hidden layer cộng với 1 output layer.
Ngoài ta, ta sẽ có 1 vòng loop trong việc thực hiện FP và BP, ví dụ ta có n hidden layers, khi đó vòng loop của ta sẽ phải chạy qua n layer. Trái với việc tính toán trước đó ta có thể dùng vectorization, việc tính toán BP và FP không thể áp dụng vectorization và ta phải lặp qua từng layer để tính toán các giá trị W, b hay a, z.

Ngoài ra, ở layer input, ta nên chú ý rằng x1,x2,x3 chỉ là input feature của 1 sample, do đó khi có m samples, thì input vector sẽ là [mx3] với 3 là số feature của 1 input, mỗi hàng là 1 sample trong input vector.

Tiếp theo ta nói về size của các tham số trong 1 mạng Deep NN.
Giả sử ta có một Deep NN như hình dưới đây, khi đó, với mỗi layer, ta kí hiện n^[k] là số unit của layer đó, ví dụ với input layer, mỗi sample được biểu diễn bởi 2 feature, do đó n^[0] = 2, tương tự n^[1] = 3.
Các w và b của các layer có số chiều tổng quát là:
W[L] = n^[L]xn^[L-1].
Ví dụ W[2] = n^[2] x n^[1] = [5x3]
b là bias của các unit trong 1 layer, do đó nếu 1 layer có n^[L] units, thì chiều của b[L] = [n^[L] x 1]
Để tính BP, dw và db có cùng số chiều với w và b

Khi ta có 1 sample, chiều của z[L] hay a[L] là [n^[L] x 1]
Khi có m sample, chiều của z[L] hay a[L] là [n^[L] x m]

Thứ Tư, 26 tháng 12, 2018

[Machine Learning] Tại sao ta thường nên dùng tanh thay vì sigmoid khi chọn activation function?

Hai hàm sigmoid và tanh có cùng trend, tuy nhiên chúng lại có đặc tính khác nhau do đặc tính đồ thị, ta quan sát đồ thị hai hàm dưới đây.


Lí do hàm tanh tốt hơn hàm sigmoid đặc biệt là trong các ứng dụng về Big data bởi vì đạo hàm của hàm tanh thường luôn có giá trị lớn hơn đạo hàm của hàm sigmoid, do đó độ dốc của hàm tanh là lớn hơn, do đó hàm lost sẽ converge nhanh hơn. Sử dụng toán học, ta có thể chứng minh rằng.
tanhx=2σ(2x)−1
Và trong hầu hết các trường hợp, ta có thể chứng minh rằng.

Trong một số trường hợp đặc biệt, ta sẽ dùng sigmoid function thay vì hàm tanh, 
ví dụ như trong bàitoán binary classification, đầu ra chỉ là 0 và 1, khi này sigmoid 
sẽ là một lựa chọn hợp lý thay vì sử dụng tanh.

Thứ Ba, 25 tháng 12, 2018

[Machine Learning] Khởi tạo các thông số weights và bias trong Shallow Neural Network

Một mạng nơ ron nông (shallow) là một mạng có số hiddens layers là nhỏ.
Khi xây dựng một NN, một trong những điều đầu tiên ta cần làm là khởi tạo các giá trị w và b cho mạng. Ví dụ mạng dưới đây có 1 hidden layer, khi này, mỗi sample sẽ được biểu diễn bởi 2 features. Ví dụ x1 = [1x2], mà ta có z = x.wT + b và ta có 2 units ở hidden layer, do đó w1 = [2x2], và a = [1x2].[2x2] = [1x2]. Từ đó, w2 = [2x1] vì ta chỉ có 1 đầu ra [1x2].[2x1] = [1x1].
w1 = [2x2] : cột của ma trận là số unit trong hidden layer, hàng là số feature của input.
b1 = [2x1], vì ta muốn thêm bias vào các unit trong hidden layer, do đó ma trận này phải là cột.

w2 = [2x1]
b2 = [1x1]

Trong logistic regression, các tham số w và b ta có thể khởi tạo bằng 0, nhưng với neural network, việc khởi tạo các giá trị bằng 0 sẽ không hợp lý. Nếu ta thực hiện back-propagation, ta sẽ update các w như sau:
w = w - alpha.dJ/dw
dJ/dw đươc tính trong các bài trước là:
dJ/dw = x.(a-y) mà a = g(z) = g(wx + b) = g(b) vì w bằng 0 trên toàn mạng. Khi này dJ/dw = x(g(b) - y) sẽ giống nhau trên toàn mạng, khi thực hiện back-propagation, các unit là giống nhau do đó ta sẽ không thể thực hiện được deep learning khi mà ta muốn thực hiện rất nhiều hàm trên mạng.

Khi này, ta phải khởi tạo giá trị w một cách mặc định như hình dưới đây.


Lí do ta phải nhân giá trị sau khởi tạo với hằng số 0.01 mà không phải 10 hay 100, -100 ... là bởi vì nếu giá trị |w| lớn, khi đó giá trị z lớn, mà theo đồ thị hàm tanh như trên, nếu giá trị z lớn, slope của nó sẽ rất nhỏ do đó việc learning sẽ tốn rất nhiều thời gian, việc khởi tạo w này gọi là zero-centric initialization nghĩa là các giá trị w sẽ gần với giá trị 0 để đảm bảo slope lớn và việc thực hiện GD sẽ diễn ra nhanh hơn.

b và các thông số thêm vào các unit phản ảnh bias, do đó ta có thể khởi tạo các giá trị này là 0 mà không ảnh hưởng tới hoạt động của NN.

[Machine Learning] Đạo hàm của các activation functions

Như ta đã nhắc đến lúc trước, đạo hàm của 1 hàm tại một điểm là độ dốc (slope) của hàm đó tại điểm đó. Ví dụ với hàm sigmoid.
Với giá trị lớn (z = 10) hoặc z nhỏ (-10), ta có thể thấy giá trị đạo hàm tính theo công thức = 0 ứng với các vùng bão hòa của sigmoid function.
Với giá trị z - 0, g(z) = 1/2 và g'(z) = 1/4 nghĩ là độ dốc của sigmoid tại điểm z = 0 là lớn.

Ngoài ra với hàm tanh, đạo hàm là tương đương với sigmoid ngoại trừ các điểm ở chính giữa đồ thị.


Cuối cùng là hàm RELU và Leaky RELU.

Thứ Hai, 24 tháng 12, 2018

[Machine Learning] Activation functions trong Neural Networks

Mô hình của 1 mạng nơ ron có cấu trúc như sau:
Ở đây, mỗi node trong hidden layer sẽ thực hiện 2 công việc.
1. Thực hiện a = X.wT + b
2. Thực hiện z = g(a)

Trong đó g là activation function. 
Cho đến nay, ta đã nhắc tới sigmoid function như là 1 activation function có biểu thức:

Ngoài ra, còn có một số activation function khác (các activation functions đều là các hàm phi tuyến) như hình dưới đây:
Trong thực tế, ta sẽ chỉ dùng các hàm sigmoid và tanh cho output layer khi mà đầu ra cần các giá trị nằm trong khoảng (0,1) hoặc (-1,1) còn các hàm như ReLU and Leaky ReLU được sử dụng ở trong các node của hidden layers. Lý do ta không sử dụng các hàm sigmoid hay tanh trong hidden layers là khi ta thực hiện back propagation, các giá trị đạo hàm sẽ nhỏ dần khi ta đi từ phải sang trái của 1 mạng NN, đo đó Gradient Descent sẽ không thể áp dụng.

Ngoài ra, tại sao ta lại cần các activation function. Ví dụ gán trực tiếp z = a và ta không hề sử dụng hàm g. Lúc này, output và input sẽ quan hệ với nhau bởi 1 hàm tuyến tính, do đó, ta sẽ không thể có nhiều lớp.

Ta sử dụng activation functions là các hàm tuyến tính thì có được không? Hay việc sử dụng hàm phi tuyến sẽ đem lại kết quả tốt hơn?

Và tại sao ta lại cần nhiều lớp trong Neural Network?

Thứ Năm, 20 tháng 12, 2018

Cách tính toán đạo hàm với Graph

Trong ML, việc tính toán đạo hàm có rất nhiều ứng dụng (thuật toán Gradient Descent, thuật toán Back-propagation ...). Trong bài này ta sẽ tìm hiểu cách tính đạo hàm cho 1 hàm đơn giản.
Ví dụ ta có.
a = 5
b = 3
c = 2
và u = bc; v = a + u
J = 3v

Tôi sẽ giải thích hình trên. Ví dụ đầu tiên ta muốn tính dJ/dv.
Lúc này, với các đầu vào a b c đã biết, v = 5 + 2*3 = 11 nên J = 3*11 = 33.
Ví dụ ta tăng v 1 lượng nhỏ dv = 0.001, lúc này v' = v + dv = 11 + 0.001 = 11.001. Khi này J' = 3*v' = 3*11.001 = 33.003.
Lúc này, đạo hàm của J theo v được tính là. dJ/dv = (33.003-33)/(11.001-11) = 3.

Tiếp theo ta muốn tính dJ/da.
dJ/da = (dJ/dv)*(dv/da) (chain rules)
mà (dJ/dv) = 3 đã được tính ở trên

Đầu vào cho a = 5 nên v = 11
Khi ta tăng 1 lượng da = 0.001 thì a' = a + da = 5.001.
v' = a' + bc = 5.001 + 2*3 = 11.001
Tương tự như trên. dv/da = (11.001 - 11)/(5.001 - 5) = 1.
Từ đó theo chain rule ta có dJ/da = 3*1 = 3


Tương tự, ta tính được các đạo hàm sau.
dJ/du = 3
dJ/db = 6
dJ/da = 9

Tương tự ta có cách tính các đạo hàm cho Logistic Regression dựa vào graph như sau:


[Machine Learning] Gradient Descent

Như đã nhắc ở trong bài về Logistic Regression, miễn là hàm loss là convex, khi đó ta sẽ luôn tìm được một điểm cực tiểu duy nhất ứng với các thông số w và b ta cần tìm. Do đó, ta có thể tùy ý khởi tạo các giá trị w và b này và sẽ thu được giá trị w và b tại điểm cực tiểu, tất nhiên nếu may mắn, ta khởi tạo w và b gần điểm cực tiểu, quá trình tìm sẽ diễn ra nhanh hơn và ngược lại.

Thuật toán Gradient Descent là phương pháp mà ta sẽ giảm dần dần giá trị của hàm loss function đến một giá trị cực tiểu, ở đó ta lấy ra giá trị w và b. Giả sử loss function được định nghĩa là J, lúc này để dễ cho biểu diễn, ta sẽ bỏ qua thành phần bias b, khi này hàm loss sẽ là J(w) vì loss lúc này chỉ phụ thuộc vào w.

α được gọi là learning rate, tham số quyết định tốc độ của gradient descent.
dw là đạo hàm của hàm loss.
Hoạt động của Gradient Descent được mô tả ở hình dưới đây:

Đầu tiên ta khởi tạo giá trị w là 1 điểm nằm trên trục ngang của đồ thị, khi này nếu ta đi từ phải sang trái tương ứng với w giảm 1 bước đủ nhỏ sao cho không quá giá trị cực tiểu, giá trị J(w) cũng sẽ giảm, khi đó hiệu của J(w) giữa 2 điểm được định nghĩa là dJ(w) (hiệu của J(w) trước khi dịch w và sau khi dịch w) và hiệu giữa 2 điểm w là d(w). Khi đó ta thấy giá trị dJ(w) là dương, do đó theo công thức tính w ở hình trên, w sẽ giảm. Miễn là giá trị dJ(w) dương, ta có thể khẳng định ta đang đi đúng hướng đến điểm cực tiểu.  

Hãy cùng hiểu bản chất của Gradient descent nào.
Đầu tiên, nhìn vào hình bên trên, ta thấy ta sẽ có 4 hướng đi
1) Từ bên trái đến điểm cực tiểu, chiều w tăng dần.
2) Từ bên trái đến điểm cực tiểu, chiều w giảm dần
3) Từ điểm cực tiểu đến bên phải, chiều w tăng dần
4) Từ điểm cực tiểu đến bên phải, chiều w giảm dần

1) Khi này dw âm, và dJ(w) dương, do đó w sẽ tăng => tiến đến Wexpect
2) Khi này dw dương, và dJ(w) âm, do đó w sẽ tăng => tiến đến Wexpect
3) Khi này dw âm, và dJ(w) âm, do đó w giảm => tiến đến Wexpect
4) Khi này dw dương, và dJ(w) dương, do đó w tăng => tiến đến Wexpect

Từ đó ta thấy, miễn hàm loss là một hàm convex, ta sẽ luôn tiến tới điểm cực tiểu.
Tuy nhiên, tham số α cũng đóng vai trò quan trọng trong việc tìm điểm cực tiểu này, nếu α là cực nhỏ, ta sẽ đảm bảo được việc tìm w sẽ chính xác nhưng khi đó w sẽ tăng hoặc giảm rất chậm, do đó mất thời gian. Nếu α lớn, ta có thể gặp tình trạng overshoot. Cả hai trường hợp được mô tả như hình dưới đây.

Thứ Tư, 19 tháng 12, 2018

[Machine Learning] Logistic Regression

Logistic Regression được sử dụng trong bài toán Binary Classification nghĩa là output chỉ nhận hai giá trị là 0 và 1. Ví dụ đầu và là 1 bức ảnh:

Khi này, đầu ra của ta sẽ là 0 hoặc 1 tương ứng với không có mèo trong ảnh và có mèo trong ảnh.
Nhưng giá trị Ŷ được tính như sau:
Ta có thể thấy, giá trị này có thể là một số thực tùy ý, khi đó, ta sẽ phải áp dụng một hàm biến đổi để biến giá trị thực này thành các giá trị 0 hoặc 1.

Từ đây ta có khái niệm mới là activation function nghĩa là hàm dùng để biến đổi đầu ra thành các giá trị ta mong muốn, ví dụ trong bài toán này ta chỉ quan tâm đến giá trị 0 hoặc 1, sigmoid function có thể được chọn là activation function và được định nghĩa như sau
Ở đây z cũng chính là giá trị Ŷ (số thực ta nhận được). Để thấy rõ hơn ta có thể nhìn đồ thị của hàm sigmoid.
Giá trị sau hàm sigmoid làm 1 số nằm trong khoảng 0 và 1 và thường xấp xỉ 2 giá trị này nên ta có thể dùng signmoid function. Vấn đề là, ta biết có 1 xác xuất rất nhỏ nhưng giá trị sigmoid có thể không gần giá trị 0 hoặc giá trị 1, ví dụ khi z = 0, signmoid = 0.5, khi này ta sẽ xử lý như thế nào? Có phải ta chấp nhận một lượng rất nhỏ sai số khi sử dụng hàm sigmoid?

Tiếp theo ta sẽ nhìn vào cost function của Logistic Regression, ta nên phân biệt giữa cost function và loss function.
Loss function tính toán lỗi cho chỉ 1 training sample
Trong khi Cost function là trung bình cộng của tất cả các loss function trong toàn bộ tập training. Bình thường, nếu giá trị trong grouth truth là y và giá trị ta thu được sau sigmoid function là Ŷ, ta có thể nghĩ ngay tới việc tính loss function như sau:


(1)
Việc ta bình phương là để tránh trường hợp giá trị này là âm cũng tương tự như ta lấy giá trị tuyệt đối, loss luôn phải dương và giá trị 1/2? Oh tại sao ta lại chọn là 1/2 nhỉ? Câu trả lời ở đây:
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Nhưng trong thực tế, loss function sẽ được định nghĩa khác.
(2)
Ta thấy rõ ràng nếu theo (1) thì công thức sẽ dễ dàng hơn nhiều.
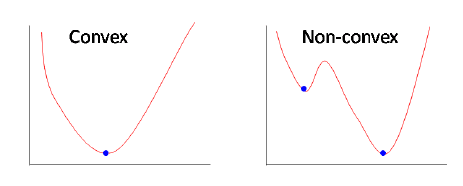
Nhưng vấn đề ở đây ta đang muốn tối ưu hàm L này, và trong bài toán tối ưu, nếu hàm loss là (1), khi đó sẽ có dạng như bên phải hình dưới đây, và là 1 dạng hàm non-convex (hàm không lồi), bởi vì nó sẽ có rất nhiều điểm cực tiểu. Ở trong hình bên phải, điểm cực tiểu là 2 điểm xanh với điểm cao hơn là cực tiêu địa phương (local optima) và điểm thấp là cực tiểu toàn cục (global optima)  - là điểm mà ta muốn tìm ứng với giá trị hàm loss là nhỏ nhất.
Với hàm số (2), lúc này dạng đồ thị sẽ là convex, khi đó chỉ có 1 cực tiểu duy nhất, lúc này việc tối ưu để tìm thông số ứng với điểm cực tiểu của hình bên trái sẽ đơn giản hơn nhiều, để tìm cực tiểu này, ta áp dụng thuật toán Gradient Descent được trình bày ở bài sau.

Với logistic regression, tổng quát lại, ta cần thay đổi các tham số w và b như hình dưới đây để có được giá trị hàm loss là nhỏ nhất.