1. Numpy arrays are element wise by default
2. Recall that "np.dot(a,b)" performs a matrix multiplication on a and b, whereas "a*b" performs an element-wise multiplication.
Chủ Nhật, 23 tháng 12, 2018

[Python Programming] Câu lệnh assert và cách dùng
Câu lệnh assert có trong hầu hết các ngôn ngữ lập trình, chúng giúp cho việc phát hiện sớm các lỗi trong chương trình, ví dụ như ta muốn kiểm tra đầu vào của một chương trình được nhập từ bán phím chẳng hạn.
Khi ta sử dụng:
assert condition
lúc này ta đang yêu cầu chương trình kiểm tra điều kiện condition và gửi về lỗi nếu điều kiện là False. Trong Python, câu lệnh này tương đương với.
Để in ra log đi cùng với assertions nếu điều kiện sai xảy ra:
if not condition:
raise AssertionError()>>> assert False
Traceback (most recent call last):
File "<stdin>", line 1, in <module>
AssertionErrorĐể in ra log đi cùng với assertions nếu điều kiện sai xảy ra:
assert False, "Oh no! This assertion failed!"-O ví dụ:
python -O script.pyThứ Năm, 20 tháng 12, 2018
Cách tính toán đạo hàm với Graph
Trong ML, việc tính toán đạo hàm có rất nhiều ứng dụng (thuật toán Gradient Descent, thuật toán Back-propagation ...). Trong bài này ta sẽ tìm hiểu cách tính đạo hàm cho 1 hàm đơn giản.


Ví dụ ta có.
a = 5
b = 3
c = 2
và u = bc; v = a + u
J = 3v

Tôi sẽ giải thích hình trên. Ví dụ đầu tiên ta muốn tính dJ/dv.
Lúc này, với các đầu vào a b c đã biết, v = 5 + 2*3 = 11 nên J = 3*11 = 33.
Ví dụ ta tăng v 1 lượng nhỏ dv = 0.001, lúc này v' = v + dv = 11 + 0.001 = 11.001. Khi này J' = 3*v' = 3*11.001 = 33.003.
Lúc này, đạo hàm của J theo v được tính là. dJ/dv = (33.003-33)/(11.001-11) = 3.
Tiếp theo ta muốn tính dJ/da.
dJ/da = (dJ/dv)*(dv/da) (chain rules)
mà (dJ/dv) = 3 đã được tính ở trên
Đầu vào cho a = 5 nên v = 11
Khi ta tăng 1 lượng da = 0.001 thì a' = a + da = 5.001.
v' = a' + bc = 5.001 + 2*3 = 11.001
Tương tự như trên. dv/da = (11.001 - 11)/(5.001 - 5) = 1.
Từ đó theo chain rule ta có dJ/da = 3*1 = 3
Lúc này, với các đầu vào a b c đã biết, v = 5 + 2*3 = 11 nên J = 3*11 = 33.
Ví dụ ta tăng v 1 lượng nhỏ dv = 0.001, lúc này v' = v + dv = 11 + 0.001 = 11.001. Khi này J' = 3*v' = 3*11.001 = 33.003.
Lúc này, đạo hàm của J theo v được tính là. dJ/dv = (33.003-33)/(11.001-11) = 3.
Tiếp theo ta muốn tính dJ/da.
dJ/da = (dJ/dv)*(dv/da) (chain rules)
mà (dJ/dv) = 3 đã được tính ở trên
Đầu vào cho a = 5 nên v = 11
Khi ta tăng 1 lượng da = 0.001 thì a' = a + da = 5.001.
v' = a' + bc = 5.001 + 2*3 = 11.001
Tương tự như trên. dv/da = (11.001 - 11)/(5.001 - 5) = 1.
Từ đó theo chain rule ta có dJ/da = 3*1 = 3

Tương tự, ta tính được các đạo hàm sau.
dJ/du = 3
dJ/db = 6
dJ/da = 9
Tương tự ta có cách tính các đạo hàm cho Logistic Regression dựa vào graph như sau:

[Machine Learning] Gradient Descent
Như đã nhắc ở trong bài về Logistic Regression, miễn là hàm loss là convex, khi đó ta sẽ luôn tìm được một điểm cực tiểu duy nhất ứng với các thông số w và b ta cần tìm. Do đó, ta có thể tùy ý khởi tạo các giá trị w và b này và sẽ thu được giá trị w và b tại điểm cực tiểu, tất nhiên nếu may mắn, ta khởi tạo w và b gần điểm cực tiểu, quá trình tìm sẽ diễn ra nhanh hơn và ngược lại.
Thuật toán Gradient Descent là phương pháp mà ta sẽ giảm dần dần giá trị của hàm loss function đến một giá trị cực tiểu, ở đó ta lấy ra giá trị w và b. Giả sử loss function được định nghĩa là J, lúc này để dễ cho biểu diễn, ta sẽ bỏ qua thành phần bias b, khi này hàm loss sẽ là J(w) vì loss lúc này chỉ phụ thuộc vào w.


Hãy cùng hiểu bản chất của Gradient descent nào.
Đầu tiên, nhìn vào hình bên trên, ta thấy ta sẽ có 4 hướng đi
1) Từ bên trái đến điểm cực tiểu, chiều w tăng dần.
2) Từ bên trái đến điểm cực tiểu, chiều w giảm dần
3) Từ điểm cực tiểu đến bên phải, chiều w tăng dần
4) Từ điểm cực tiểu đến bên phải, chiều w giảm dần
1) Khi này dw âm, và dJ(w) dương, do đó w sẽ tăng => tiến đến Wexpect
2) Khi này dw dương, và dJ(w) âm, do đó w sẽ tăng => tiến đến Wexpect
3) Khi này dw âm, và dJ(w) âm, do đó w giảm => tiến đến Wexpect
4) Khi này dw dương, và dJ(w) dương, do đó w tăng => tiến đến Wexpect
Từ đó ta thấy, miễn hàm loss là một hàm convex, ta sẽ luôn tiến tới điểm cực tiểu.
Tuy nhiên, tham số α cũng đóng vai trò quan trọng trong việc tìm điểm cực tiểu này, nếu α là cực nhỏ, ta sẽ đảm bảo được việc tìm w sẽ chính xác nhưng khi đó w sẽ tăng hoặc giảm rất chậm, do đó mất thời gian. Nếu α lớn, ta có thể gặp tình trạng overshoot. Cả hai trường hợp được mô tả như hình dưới đây.

Thuật toán Gradient Descent là phương pháp mà ta sẽ giảm dần dần giá trị của hàm loss function đến một giá trị cực tiểu, ở đó ta lấy ra giá trị w và b. Giả sử loss function được định nghĩa là J, lúc này để dễ cho biểu diễn, ta sẽ bỏ qua thành phần bias b, khi này hàm loss sẽ là J(w) vì loss lúc này chỉ phụ thuộc vào w.

α được gọi là learning rate, tham số quyết định tốc độ của gradient descent.
dw là đạo hàm của hàm loss.
Hoạt động của Gradient Descent được mô tả ở hình dưới đây:
Đầu tiên ta khởi tạo giá trị w là 1 điểm nằm trên trục ngang của đồ thị, khi này nếu ta đi từ phải sang trái tương ứng với w giảm 1 bước đủ nhỏ sao cho không quá giá trị cực tiểu, giá trị J(w) cũng sẽ giảm, khi đó hiệu của J(w) giữa 2 điểm được định nghĩa là dJ(w) (hiệu của J(w) trước khi dịch w và sau khi dịch w) và hiệu giữa 2 điểm w là d(w). Khi đó ta thấy giá trị dJ(w) là dương, do đó theo công thức tính w ở hình trên, w sẽ giảm. Miễn là giá trị dJ(w) dương, ta có thể khẳng định ta đang đi đúng hướng đến điểm cực tiểu.
Hãy cùng hiểu bản chất của Gradient descent nào.
Đầu tiên, nhìn vào hình bên trên, ta thấy ta sẽ có 4 hướng đi
1) Từ bên trái đến điểm cực tiểu, chiều w tăng dần.
2) Từ bên trái đến điểm cực tiểu, chiều w giảm dần
3) Từ điểm cực tiểu đến bên phải, chiều w tăng dần
4) Từ điểm cực tiểu đến bên phải, chiều w giảm dần
1) Khi này dw âm, và dJ(w) dương, do đó w sẽ tăng => tiến đến Wexpect
2) Khi này dw dương, và dJ(w) âm, do đó w sẽ tăng => tiến đến Wexpect
3) Khi này dw âm, và dJ(w) âm, do đó w giảm => tiến đến Wexpect
4) Khi này dw dương, và dJ(w) dương, do đó w tăng => tiến đến Wexpect
Từ đó ta thấy, miễn hàm loss là một hàm convex, ta sẽ luôn tiến tới điểm cực tiểu.
Tuy nhiên, tham số α cũng đóng vai trò quan trọng trong việc tìm điểm cực tiểu này, nếu α là cực nhỏ, ta sẽ đảm bảo được việc tìm w sẽ chính xác nhưng khi đó w sẽ tăng hoặc giảm rất chậm, do đó mất thời gian. Nếu α lớn, ta có thể gặp tình trạng overshoot. Cả hai trường hợp được mô tả như hình dưới đây.

Thứ Tư, 19 tháng 12, 2018
[Machine Learning] Logistic Regression
Logistic Regression được sử dụng trong bài toán Binary Classification nghĩa là output chỉ nhận hai giá trị là 0 và 1. Ví dụ đầu và là 1 bức ảnh:
 Khi này, đầu ra của ta sẽ là 0 hoặc 1 tương ứng với không có mèo trong ảnh và có mèo trong ảnh.
Nhưng giá trị Ŷ được tính như sau:
 Ta có thể thấy, giá trị này có thể là một số thực tùy ý, khi đó, ta sẽ phải áp dụng một hàm biến đổi để biến giá trị thực này thành các giá trị 0 hoặc 1.
Từ đây ta có khái niệm mới là activation function nghĩa là hàm dùng để biến đổi đầu ra thành các giá trị ta mong muốn, ví dụ trong bài toán này ta chỉ quan tâm đến giá trị 0 hoặc 1, sigmoid function có thể được chọn là activation function và được định nghĩa như sau
 Ở đây z cũng chính là giá trị Ŷ (số thực ta nhận được). Để thấy rõ hơn ta có thể nhìn đồ thị của hàm sigmoid.
 Giá trị sau hàm sigmoid làm 1 số nằm trong khoảng 0 và 1 và thường xấp xỉ 2 giá trị này nên ta có thể dùng signmoid function. Vấn đề là, ta biết có 1 xác xuất rất nhỏ nhưng giá trị sigmoid có thể không gần giá trị 0 hoặc giá trị 1, ví dụ khi z = 0, signmoid = 0.5, khi này ta sẽ xử lý như thế nào? Có phải ta chấp nhận một lượng rất nhỏ sai số khi sử dụng hàm sigmoid?
Tiếp theo ta sẽ nhìn vào cost function của Logistic Regression, ta nên phân biệt giữa cost function và loss function.
Loss function tính toán lỗi cho chỉ 1 training sample
Trong khi Cost function là trung bình cộng của tất cả các loss function trong toàn bộ tập training. Bình thường, nếu giá trị trong grouth truth là y và giá trị ta thu được sau sigmoid function là Ŷ, ta có thể nghĩ ngay tới việc tính loss function như sau:
 (1)
Việc ta bình phương là để tránh trường hợp giá trị này là âm cũng tương tự như ta lấy giá trị tuyệt đối, loss luôn phải dương và giá trị 1/2? Oh tại sao ta lại chọn là 1/2 nhỉ? Câu trả lời ở đây:
https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Nhưng trong thực tế, loss function sẽ được định nghĩa khác.
 (2)
Ta thấy rõ ràng nếu theo (1) thì công thức sẽ dễ dàng hơn nhiều.
Nhưng vấn đề ở đây ta đang muốn tối ưu hàm L này, và trong bài toán tối ưu, nếu hàm loss là (1), khi đó sẽ có dạng như bên phải hình dưới đây, và là 1 dạng hàm non-convex (hàm không lồi), bởi vì nó sẽ có rất nhiều điểm cực tiểu. Ở trong hình bên phải, điểm cực tiểu là 2 điểm xanh với điểm cao hơn là cực tiêu địa phương (local optima) và điểm thấp là cực tiểu toàn cục (global optima) - là điểm mà ta muốn tìm ứng với giá trị hàm loss là nhỏ nhất.
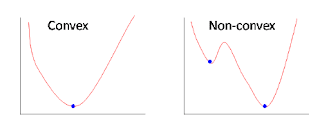 Với hàm số (2), lúc này dạng đồ thị sẽ là convex, khi đó chỉ có 1 cực tiểu duy nhất, lúc này việc tối ưu để tìm thông số ứng với điểm cực tiểu của hình bên trái sẽ đơn giản hơn nhiều, để tìm cực tiểu này, ta áp dụng thuật toán Gradient Descent được trình bày ở bài sau.
Với logistic regression, tổng quát lại, ta cần thay đổi các tham số w và b như hình dưới đây để có được giá trị hàm loss là nhỏ nhất.
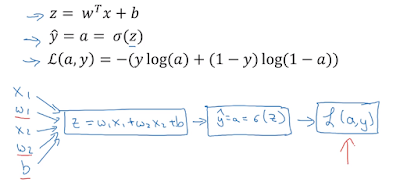

Nhưng giá trị Ŷ được tính như sau:

Từ đây ta có khái niệm mới là activation function nghĩa là hàm dùng để biến đổi đầu ra thành các giá trị ta mong muốn, ví dụ trong bài toán này ta chỉ quan tâm đến giá trị 0 hoặc 1, sigmoid function có thể được chọn là activation function và được định nghĩa như sau


Tiếp theo ta sẽ nhìn vào cost function của Logistic Regression, ta nên phân biệt giữa cost function và loss function.
Loss function tính toán lỗi cho chỉ 1 training sample
Trong khi Cost function là trung bình cộng của tất cả các loss function trong toàn bộ tập training. Bình thường, nếu giá trị trong grouth truth là y và giá trị ta thu được sau sigmoid function là Ŷ, ta có thể nghĩ ngay tới việc tính loss function như sau:
(1)https://datascience.stackexchange.com/questions/10188/why-do-cost-functions-use-the-square-error
Nhưng trong thực tế, loss function sẽ được định nghĩa khác.
 (2)
Nhưng vấn đề ở đây ta đang muốn tối ưu hàm L này, và trong bài toán tối ưu, nếu hàm loss là (1), khi đó sẽ có dạng như bên phải hình dưới đây, và là 1 dạng hàm non-convex (hàm không lồi), bởi vì nó sẽ có rất nhiều điểm cực tiểu. Ở trong hình bên phải, điểm cực tiểu là 2 điểm xanh với điểm cao hơn là cực tiêu địa phương (local optima) và điểm thấp là cực tiểu toàn cục (global optima) - là điểm mà ta muốn tìm ứng với giá trị hàm loss là nhỏ nhất.
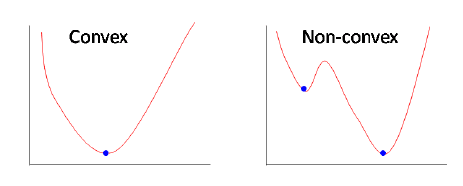
Với logistic regression, tổng quát lại, ta cần thay đổi các tham số w và b như hình dưới đây để có được giá trị hàm loss là nhỏ nhất.
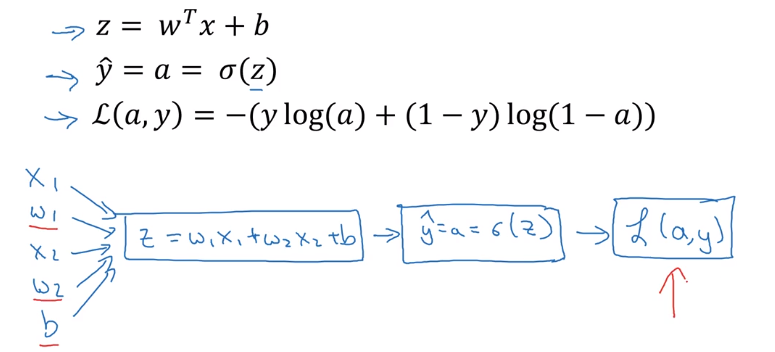
Thứ Ba, 18 tháng 12, 2018
[Machine Learning] Lộ trình học Deep Learning bắt đầu từ con số 0
Khi mới sang đây học từ tháng 9/2018, tôi khá bỡ ngỡ và không nghĩ mình nên học về AI, nhưng chỉ sau 1 tháng ở đây, tôi đã nhận ra việc học AI là một điều kiện tiên quyết dù có thích hay không để phát triển bản thân và cơ hội nghề nghiệp. Ở Việt Nam, khi nói tới AI hay Machine Learning, nó là một thứ gì đó xa xỉ và thường là ở các cuộc hội thảo khi mà các ông diễn giả chém gió là giỏi chứ thực chất chưa động tay vào xây dựng một mô hình AI tử tế bao giờ (chém gió ăn tiền chứ kiến thức rỗng tuếch), thì ở đây, nó là một thứ được nhắc tới thường ngày, ở trên lớp, cuộc họp và trong các câu chuyện phiếm thường nhật giữa 2 sinh viên.
Lúc đó, tôi khá mông lung không biết học từ đâu, tôi đã xem qua thử cuốn Machine Learning cơ bản của anh Vũ Hữu Tiệp, nhưng thực sự tôi thấy cách diễn giải khá lan man, và sẽ ít người đủ kiên nhẫn để theo đuổi. Cái thứ hai tôi không thích ở các cuốn sách về ML hiện nay (mới có 1 nhóm các bạn Việt Nam mới dịch thêm 1 cuốn) bởi vì các thuật ngữ đặc biệt "domain-specific" được dịch ra tiếng Việt. Dạo qua 1 vòng thì ngoài diễn đàn machinelearning cơ bản các tài liệu khác thường là rất manh mún và chắp vá.
Sau đó, tôi thử học khóa Machine Learning trên Coursera của Andrew Ng, và thực sự thấy đây là thứ tôi đang tìm, khóa học trình bày rất tổng quan về ML, nhiều kiến thức rất hay nhưng do lúc đó tôi mới học nên chưa thấm được hết, nhưng sau đó gặp cái gì đó là xem lại, thấy kiến thức ông nói rất xúc tích và chính xác. Mọi người cứ muốn đào sâu vào học cái khó cho nên họ recommend tôi học khóa CS231n của Stanford, nhưng tôi luôn nghĩ xây dựng từ cơ bản là tốt nhất, cho nên, tôi đã dành nguyên 1 tháng để tự học khóa này.
 Sau đó, tôi định học khóa CS231n, theo tôi cảm nhận, người dạy khóa này kiến thức và khả năng truyền đạt không thể bằng Andrew Ng được, thêm vào đó assignment là khá nhiều và đòi hỏi người học phải tự đọc thêm nhiều, và lúc đó đang đợt ôn thi nên tôi cũng học qua vài lecture rồi bỏ.
Sau khi thi học kì thứ nhất xong, thời gian lại rảnh lại có để tự học, có lẽ tôi là fan của Andrew Ng nên tôi thích nghe giọng ông giảng, do đó tôi đang theo học khóa Deep Learning Specialization trên deeplearning.ai của ông. Do tôi định đi theo mảng NLP nên dù khóa này có tận 5 khóa con, nhưng tôi chỉ học Course 1 và week 1 của Course 5 nói về RNN.
Tiếp theo, tôi đọc bài Host load prediction with long short-term memory in cloud computing để tìm hiểu về Time-series prediction sử dụng RNN, bởi vì có 1 anh cùng lab làm về mảng này và recommend tôi đọc. Khi đã đọc hiểu rồi, để implement, cần học DL framework như TensorFlow hoặc Pytorch, và cá nhân tôi chọn học Pytorch qua khóa Intro to Deep Learning with PyTorch trên Udacity theo lời khuyên của labmate.
Khóa Deep Learning with PyTorch trên Udacity khá hay, ngoài lý thuyết ta còn được code do đó việc hiểu về CNN và RNN sẽ rõ ràng hơn rất nhiều, trong course này có 2 phần là Style Transfer và Sentiment Analysis là phần mở rộng của CNN và RNN, ta có thể học nếu hứng thú, tuy nhiên, tôi bỏ qua 2 phần này.
Tiếp theo, ta quay lại xem qua lecture về CNN và RNN của CS231n, lúc này, kiến thứ thực sự dễ hiểu, dù sao đi nữa CS231n là khóa học về DL thực sự gần như là tốt nhất về mặt lý thuyết, nên khi đã có đủ kiến thức nền, việc nghe các bài giảng trên CS231n như một cách nhắc lại và hệ thống kiến thức hoàn chỉnh.
Lúc đó, tôi khá mông lung không biết học từ đâu, tôi đã xem qua thử cuốn Machine Learning cơ bản của anh Vũ Hữu Tiệp, nhưng thực sự tôi thấy cách diễn giải khá lan man, và sẽ ít người đủ kiên nhẫn để theo đuổi. Cái thứ hai tôi không thích ở các cuốn sách về ML hiện nay (mới có 1 nhóm các bạn Việt Nam mới dịch thêm 1 cuốn) bởi vì các thuật ngữ đặc biệt "domain-specific" được dịch ra tiếng Việt. Dạo qua 1 vòng thì ngoài diễn đàn machinelearning cơ bản các tài liệu khác thường là rất manh mún và chắp vá.
Sau đó, tôi thử học khóa Machine Learning trên Coursera của Andrew Ng, và thực sự thấy đây là thứ tôi đang tìm, khóa học trình bày rất tổng quan về ML, nhiều kiến thức rất hay nhưng do lúc đó tôi mới học nên chưa thấm được hết, nhưng sau đó gặp cái gì đó là xem lại, thấy kiến thức ông nói rất xúc tích và chính xác. Mọi người cứ muốn đào sâu vào học cái khó cho nên họ recommend tôi học khóa CS231n của Stanford, nhưng tôi luôn nghĩ xây dựng từ cơ bản là tốt nhất, cho nên, tôi đã dành nguyên 1 tháng để tự học khóa này.

Sau khi thi học kì thứ nhất xong, thời gian lại rảnh lại có để tự học, có lẽ tôi là fan của Andrew Ng nên tôi thích nghe giọng ông giảng, do đó tôi đang theo học khóa Deep Learning Specialization trên deeplearning.ai của ông. Do tôi định đi theo mảng NLP nên dù khóa này có tận 5 khóa con, nhưng tôi chỉ học Course 1 và week 1 của Course 5 nói về RNN.
Tiếp theo, tôi đọc bài Host load prediction with long short-term memory in cloud computing để tìm hiểu về Time-series prediction sử dụng RNN, bởi vì có 1 anh cùng lab làm về mảng này và recommend tôi đọc. Khi đã đọc hiểu rồi, để implement, cần học DL framework như TensorFlow hoặc Pytorch, và cá nhân tôi chọn học Pytorch qua khóa Intro to Deep Learning with PyTorch trên Udacity theo lời khuyên của labmate.
Khóa Deep Learning with PyTorch trên Udacity khá hay, ngoài lý thuyết ta còn được code do đó việc hiểu về CNN và RNN sẽ rõ ràng hơn rất nhiều, trong course này có 2 phần là Style Transfer và Sentiment Analysis là phần mở rộng của CNN và RNN, ta có thể học nếu hứng thú, tuy nhiên, tôi bỏ qua 2 phần này.
Tiếp theo, ta quay lại xem qua lecture về CNN và RNN của CS231n, lúc này, kiến thứ thực sự dễ hiểu, dù sao đi nữa CS231n là khóa học về DL thực sự gần như là tốt nhất về mặt lý thuyết, nên khi đã có đủ kiến thức nền, việc nghe các bài giảng trên CS231n như một cách nhắc lại và hệ thống kiến thức hoàn chỉnh.
Thứ Bảy, 8 tháng 12, 2018
[Machine Learning] Terminologies in Neural Network
In the neural network terminology:
- one epoch = one forward pass and one backward pass of all the training examples
- batch size = the number of training examples in one forward/backward pass. The higher the batch size, the more memory space you'll need.
- number of iterations = number of passes, each pass using [batch size] number of examples. To be clear, one pass = one forward pass + one backward pass (we do not count the forward pass and backward pass as two different passes).
Đăng ký:
Bài đăng (Atom)